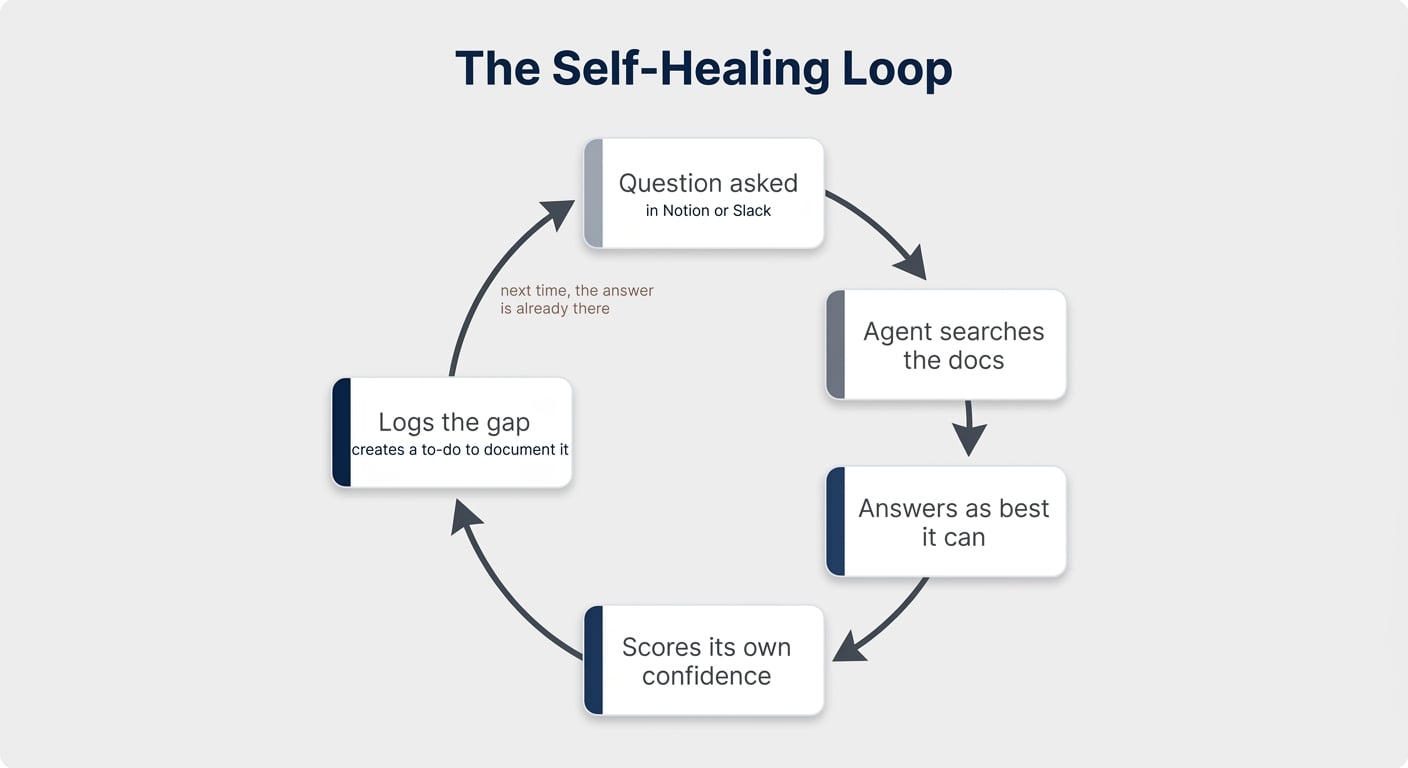
Notion Agents sind unglaublich mächtig. Und unglaublich leicht, damit zu viel Geld auszugeben. Mit Notion Credits, die ab dem 4. Mai 2026 live gehen, hat jeder Custom-Agent-Run einen Preisschild – und wenn du immer noch Opus für jede einzelne Aufgabe einsetzt, verbrennst du buchstäblich Geld.
Ich lasse Custom Agents seit Monaten in Kundenprojekten und eigenen internen Workflows laufen. Das sind die drei Prinzipien, die unsere KI-Kosten konsistent um 60–80 % senken – ohne Abstriche bei der Ausgabequalität. Plus zwei Bonus-Überlegungen, die dir vielleicht noch mehr sparen.
Welches Modell solltest du für deinen Notion Agent verwenden?
Wir alle haben ein Vorschlaghammer-Problem. Als Custom Agents noch kostenlos waren, gab es keinen Grund, nicht das größte, beste Modell für jeden Job zu nehmen. Opus für alles. Warum nicht?
Weil Opus wahnsinnig teuer ist. Und jetzt, wo wir für Compute bezahlen, lohnt es sich zu fragen: Braucht dieser Job wirklich die erfahrenste, bestbezahlte Person im Raum?
Hier ein kurzer Kostenvergleich für gängige Agent-Aufgaben:
| Aufgabe | Opus-Kosten | Haiku-Kosten | Ersparnis |
|---|---|---|---|
| 10.000 Support-Tickets (routen & verarbeiten) | ~30 $ | ~6 $ | 80 % |
| Artikel-Zusammenfassung | Hoch | ~1/5 | 80 % |
| Rechnungsdaten extrahieren | Hoch | ~1/5 | 80 % |
| Klassifizierung & Formatierung | Hoch | ~1/5 | 80 % |
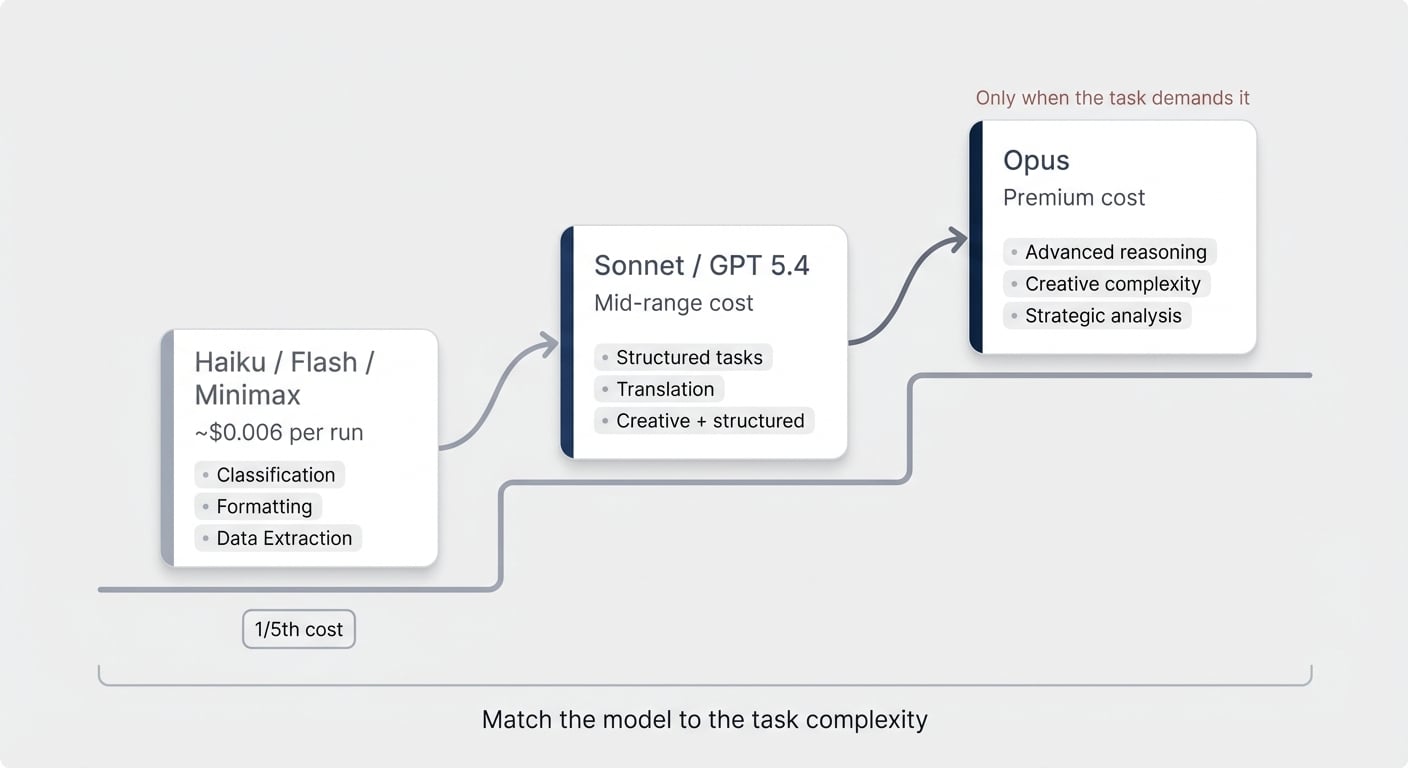
Haiku kostet ein Fünftel von Opus. Durchgehend. Für Aufgaben wie Routing, Extrahieren, Klassifizieren und Zusammenfassen bedeutet das 80 % Ersparnis – allein durch den Modellwechsel.
Natürlich kann nicht jeder Job an Haiku delegiert werden. Es ist ein weniger leistungsfähiges Modell. Die Entscheidung hängt davon ab, was der Job tatsächlich erfordert:
- Komplexes Reasoning, kreative Komplexität, tiefgehende Analyse – Opus. Zahl den Aufpreis. Es lohnt sich hier.
- Mittleres Reasoning, strukturierte Aufgaben – Sonnet 4.6 oder GPT-5.5. Deutlich günstiger als Opus. GPT-5.5 ist stark bei Reasoning-Aufgaben, hat aber weniger Persönlichkeit (nicht ideal für einen täglichen Assistenten, aber solide für logiklastige Hintergrundarbeit).
- Einfache Operationen: Formatierung, Klassifizierung, Extraktion, Zusammenfassung – Haiku, Gemini Flash oder Minimax. Perfekt für zielgerichtete, wiederholbare Aufgaben.
Ein konkretes Beispiel: Unser Content-Link-Optimierer läuft jedes Mal, wenn wir einen Blog-Beitrag veröffentlichen. Er prüft interne Links, setzt Affiliate-Referenzen und bereinigt die Formatierung. Fünf Runs diesen Monat. Gesamtverbrauch: 72 Credits. Ein einziger Opus-Run für einen Artikel würde mehr kosten als das.
Pro-Tipp: Setz das Modell explizit. Geh zu den Einstellungen deines Agents → scrolle zu Erweitert → Modell. Lass es nie auf Auto. Auto übergibt die Modellwahl an den Agent – und diese Entscheidung ist deine Aufgabe als Architekt. Entweder die Aufgabe braucht Opus-Level-Reasoning, oder nicht. Triff die Entscheidung. Daneben findest du Effort – das steuert, wie intensiv das gewählte Modell pro Run denkt. Der Standard ist gut; es ist der Regler, den du anpasst, wenn ein Agent mehr kostet, als sein Job wert ist.
Noch etwas zur Modellauswahl: Die Warnungen, die bei kleineren Modellen erscheinen (wie Prompt-Injection-Risiken), sind es wert, gelesen zu werden – aber kein Grund zur Panik. Prompt Injection ist nur dann ein echtes Angriffsszenario, wenn dein Agent externe, unkontrollierte Eingaben verarbeitet – eingehende E-Mails, Website-Formulare, öffentliche Daten. Wenn er interne Inhalte verarbeitet (ein Team-Slack-Kanal, deine eigenen Datenbanken), ist das Risiko minimal. Heb das klügere Modell für den externen Anwendungsfall auf.
Warum ein großer Agent mehr kostet als fünf kleine
Das ist die Erkenntnis, die die meisten überrascht. Einen Agent aufzuteilen spart tatsächlich Geld.
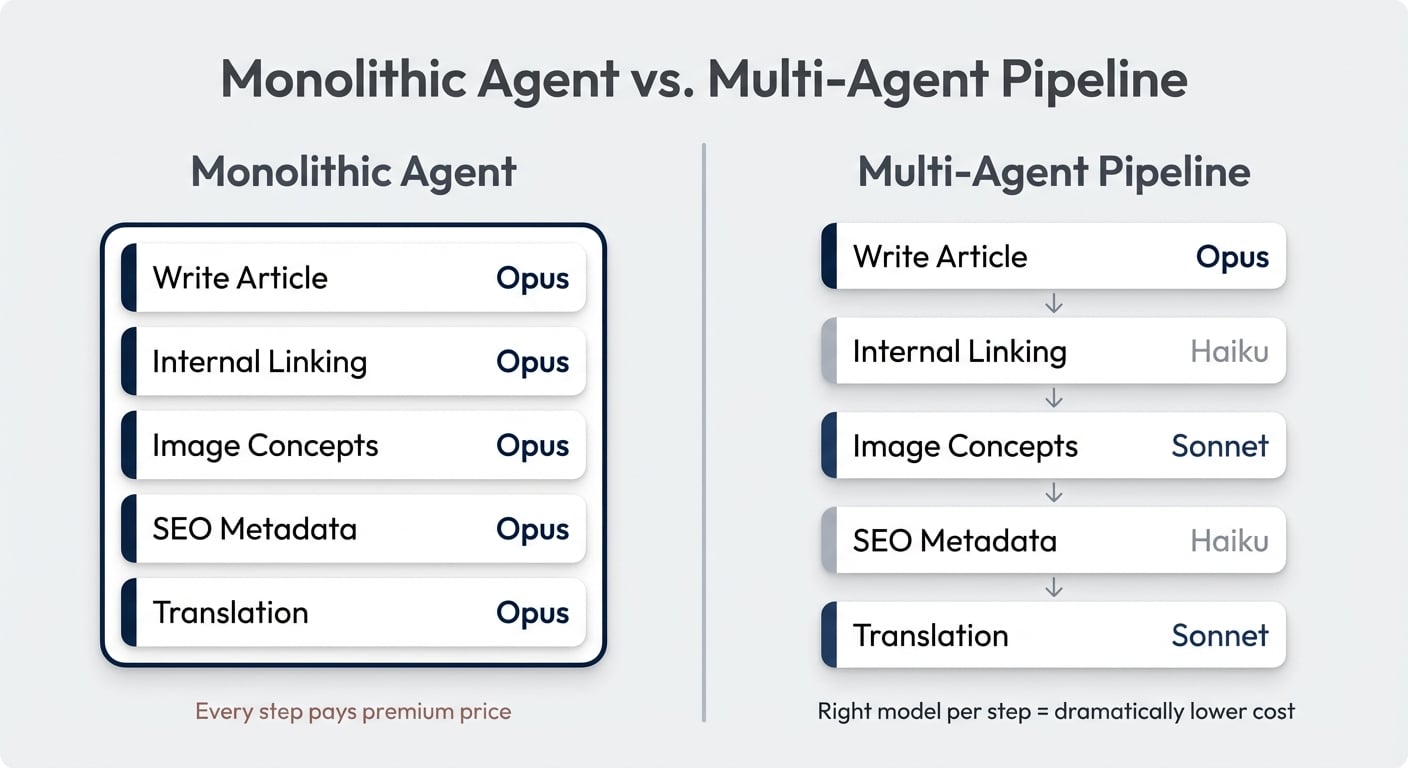
Hier liegt die Falle: Du baust einen Agent für einen gesamten Workflow. Blog-Post-Erstellung zum Beispiel. Der Agent liest das Transkript, schreibt den Artikel, findet interne Links, generiert Bildkonzepte, schreibt SEO-Metadaten und übersetzt vielleicht noch das Ergebnis. Weil der Schreib-Schritt fortgeschrittenes Reasoning erfordert, setzt du alles auf Opus.
Jetzt läuft jeder Schritt auf Opus. Der Linking-Schritt, den Haiku in Sekunden erledigen könnte? Opus. Die Metadaten-Extraktion? Opus. Die Übersetzung? Opus.
In einem monolithischen Agent bestimmt die komplexeste Teilaufgabe das Modell für alles.
Teile es auf:
- Artikel schreiben → Opus (hier lebt das Reasoning)
- Interne Verlinkung → Haiku (Pattern-Matching, einfache Lookups)
- Bildkonzepte → Sonnet (kreativ, aber strukturiert)
- SEO-Metadaten → Haiku (Extraktion und Formatierung)
- Übersetzung → Sonnet oder Haiku (je nach Komplexität)
Fünf Agents. Drei verschiedene Modell-Tiers. Dramatisch niedrigere Gesamtkosten – weil vier von fünf Schritten keine Premium-Token mehr verbrennen.
Ja, du kannst diese Multi-Agent-Orchestrierungs-Flows heute in Notion aufbauen. Ich habe kürzlich ein vollständiges Tutorial veröffentlicht, wie man das einrichtet.
Das Chaining funktioniert über Datenbank-Trigger: Agent A beendet seinen Job und aktualisiert eine Property → Agent B wird durch diese Änderung ausgelöst. Es ist kein direkter Agent-zu-Agent-Handoff – es ist System-Design. Und es funktioniert bemerkenswert gut.
Wie Progressive Context Disclosure deine Token-Rechnung senkt
Ein günstigeres Modell macht jeden Token günstiger. Progressive Context Disclosure reduziert, wie viele Token du überhaupt verwendest.
Der Standardansatz sieht so aus: Du schreibst ein riesiges Instruction-Set, das jeden Edge Case, jede Bedingung, jedes Referenzdokument abdeckt. Der Agent liest alles davon. Dann beginnt er mit Schritt eins. Wenn er Schritt sieben erreicht, trägt er dieses enorme Context-Window mit sich – und jeder einzelne Schritt ist teurer wegen des akkumulierten Ballasts.
Progressive Context Disclosure dreht das um. Gib dem Modell nur so viel Kontext, wie es für den nächsten spezifischen Schritt braucht.
Drei Dinge passieren:
- Bessere Ausgabe. Der Agent ist fokussierter. Weniger Rauschen, weniger Ablenkungen, genauere Ergebnisse.
- Günstigere frühe Schritte. Wenn der volle Kontext 50.000 Token beträgt, Schritt eins aber nur 5.000 benötigt – hast du gerade 90 % an diesem Schritt gespart.
- Konditionelles Laden. Manche Kontexte sind nur gelegentlich relevant. Warum solltest du deine Affiliate-Link-Datenbank in jeden einzelnen Blog-Post-Run laden, wenn die Hälfte deiner Artikel nie ein externes Tool erwähnt?
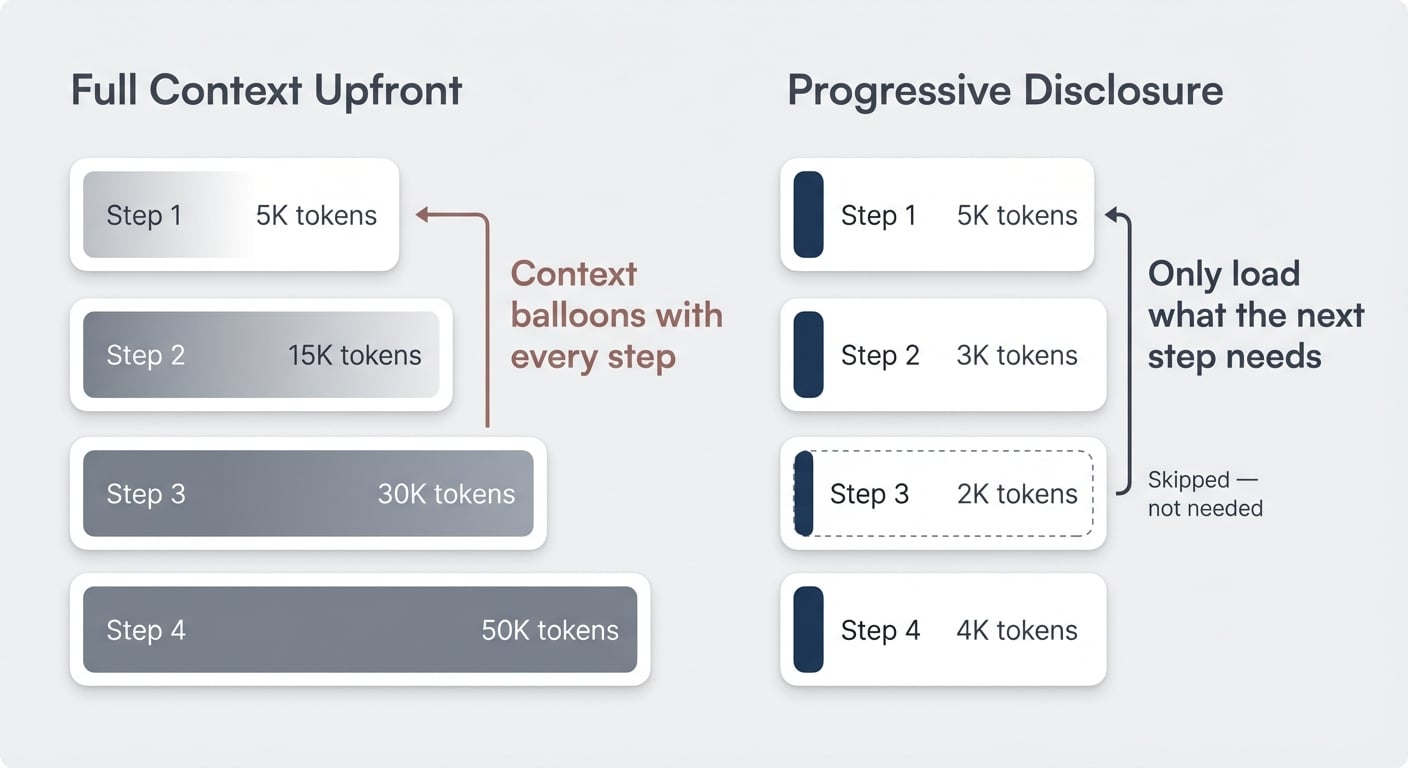
Unser Link-Optimierer macht genau das. Schritt drei seiner Instructions lautet: Prüfe, ob der Artikel irgendwelche Produkte erwähnt. Wenn ja, lade die Affiliate-Referenzseite. Wenn nicht, überspringe sie vollständig. Die meisten Runs berühren diesen Kontext nie.
Multi-Agent-Architekturen bekommen diesen Vorteil von Natur aus. In unserer Content-Pipeline wird das Transkript (das mit Abstand längste Dokument) nur vom ersten Agent gelesen. Der Link-Optimierer, der Metadaten-Agent, der Übersetzer – sie lesen nur den fertigen Blog-Post. Viel kürzer. Viel günstiger.
Ein monolithischer Agent, der denselben Workflow ausführt, würde das gesamte Transkript durch jeden Schritt schleppen, das Context-Window aufblähen und bei jedem Schritt Token verbrennen.
Behalte auch deine Output-Token im Blick
Das wird leicht übersehen. Output-Token sind über alle Modelle hinweg deutlich teurer als Input-Token. Wenn dein Agent einen halbseitigen Bericht schreibt, obwohl du nur eine Statuszeile brauchst, die bestätigt, dass der Job erledigt ist, zahlst du für Worte, die niemand liest.
Du kannst das nicht immer kontrollieren – ein Blog-schreibender Agent muss einen Blog-Post produzieren. Aber für Routing-Agents, Klassifizierungs-Agents, Datenextraktions-Agents? Sei explizit in deinen Instructions über Output-Format und -Länge. „Antworte nur mit dem Namen des zugewiesenen Owners und der Ticket-ID. Nichts weiter.” Diese Art von Präzision summiert sich.
Braucht das überhaupt KI? Der deterministische Workflow-Check
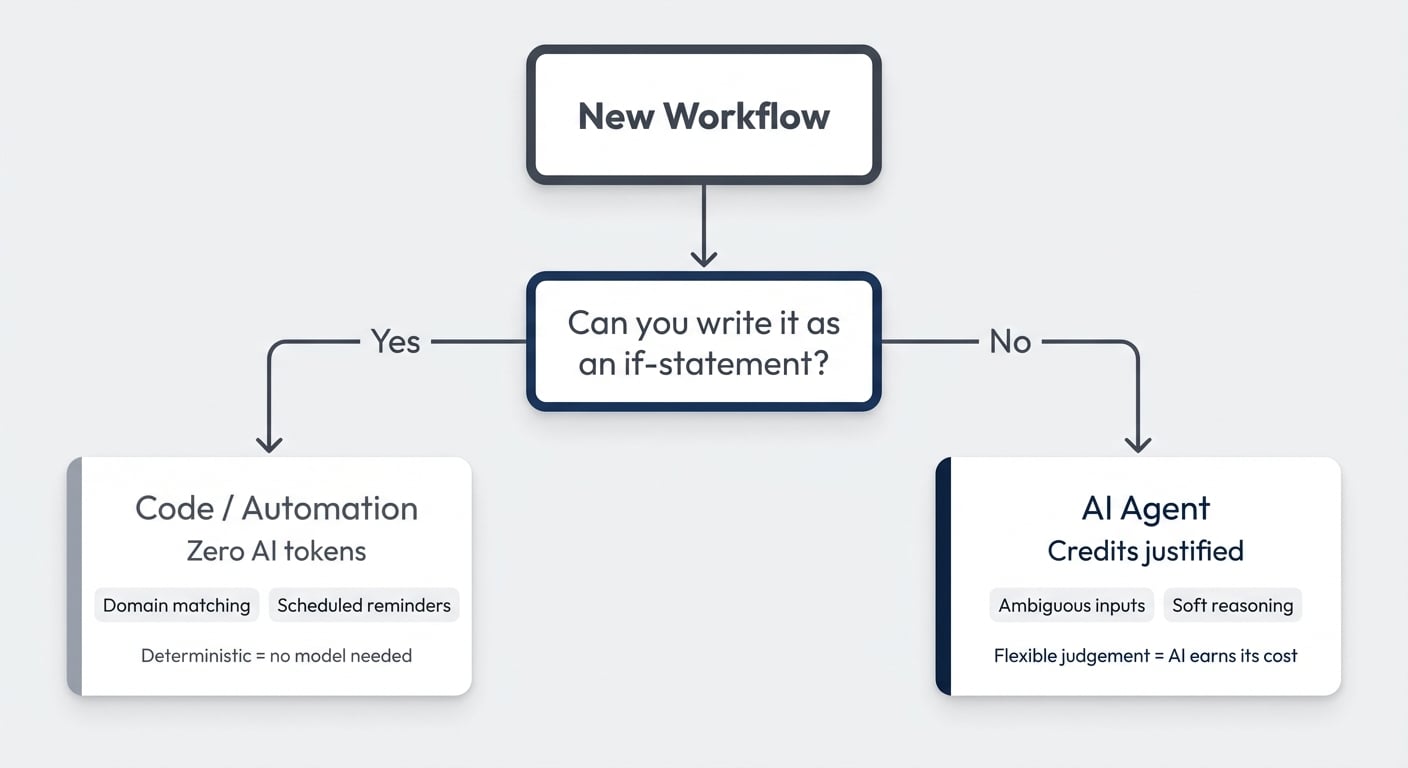
Dieses Prinzip könnte deine KI-Rechnung am stärksten senken – denn die Antwort könnte lauten: „Verwende gar keine KI.”
Deterministisch bedeutet: Der Workflow folgt festen Regeln. Wenn das, dann jenes. Kein Urteilsvermögen erforderlich. Das ist kein Job für KI. Das ist ein Job für Code oder No-Code-Automationen.
KI verdient ihren Preis, wenn du unordentliche, flexible, mehrdeutige Eingaben verarbeiten musst – die Art von weichem Reasoning, die früher einen Menschen erforderte.
Zwei Beispiele aus unseren eigenen Workflows:
Beispiel 1: Kontakt-Matching. Unser Meeting-Notes-Tool leitet Kontakte in Notion weiter. Wir müssen jeden Kontakt einem Kunden in unserem CRM zuordnen. Ein Agent könnte das tun. Aber die Logik ist einfach: Prüfe die E-Mail-Domain des neuen Kontakts → schau, ob ein Kunde diese Domain hat → wenn ja, verknüpfe sie. Das ist deterministisch. Domain-Matching. Kein Reasoning erforderlich. Eine einfache Automation erledigt das perfekt.
Beispiel 2: Erinnerungen zur Kundenkommunikation. Eines der Dinge, das Kunden bei uns regelmäßig loben, ist proaktive Kommunikation. Wir haben das standardisiert: Jeder aktive Kunde hört alle 48 Stunden von uns – Montag, Mittwoch, Freitag. Ein Agent könnte uns erinnern. Aber wenn das Projekt aktiv ist und es Montag ist, sollte die Erinnerung feuern. Keine Ermessensentscheidung. Code.
Das Muster: Wenn du die Entscheidung als If-Statement formulieren kannst, braucht sie kein Language Model.
Jetzt zwei wichtige Nuancen.
Für Team-Rollouts: Starte trotzdem mit KI. Wenn du eine KI-Aktivierungskampagne durchführst und Menschen mit Agents vertraut machen willst, lass sie KI-Flows bauen – auch für Dinge, die deterministisch sein könnten. Das Erlernen von KI hat in dieser Phase Priorität. Kostenoptimierung kommt nach der Vertrautheit.
Nutze KI, um deine deterministischen Flows zu bauen. Das ist der Verhaltensshift. KI muss keine KI-Workflows bauen. Beschreibe deine Automation in Notion, bitte deinen Agent, einen Automation-Prompt zu schreiben, füge ihn in ein Tool wie Make ein – und KI baut den deterministischen Flow für dich. Fünf Minuten. Keine stundenlangen Konfigurationssessions. Die Automation läuft ohne KI-Token. Das Beste aus beiden Welten.
Sollte das ein Skill sein statt eines Custom Agents?
Noch etwas. Vieles von dem, was ich derzeit als Custom Agents gebaut sehe, sollte gar kein Agent sein. Es sollte ein Skill für deinen persönlichen Agenten sein.
Hier die aktuelle Realität: Dein persönlicher Agent – der in deiner Seitenleiste – ist in deinem Plan enthalten. Kostenlos. Du kannst ihn für die meisten Knowledge-Work-Aufgaben auf Opus 4.8 laufen lassen. Custom Agents kosten Credits.
Die Schwellenfrage für jeden Custom Agent lautet also: Muss das ohne mich laufen?
Drei Checks:
| Frage | Wenn Ja → Agent | Wenn Nein → Skill |
|---|---|---|
| Gibt es einen zuverlässigen, wiederkehrenden Trigger? | E-Mail empfangen, Status geändert, jeden Montag 9 Uhr | Du startest es manuell aus dem Chat |
| Entfernt es deine Aufmerksamkeit vollständig? | Ticket-Routing: Niemand überwacht den Kanal mehr | Du musst noch prüfen, kopieren oder genehmigen |
| Ermöglicht es Skalierung? | Du kannst jetzt das 10-fache Volumen bewältigen | Du machst dasselbe Volumen, nur etwas schneller |
Mein größtes Warnsignal: Jemand baut einen Custom Agent und nutzt ihn dann über die Chat-Oberfläche. Mit sehr wenigen Ausnahmen (Permissions-Isolation, team-geteilte Workflows) sollte das ein Skill sein. Du sitzt bereits vor dem Computer. Du löst die Aufgabe bereits aus. Führe es über deinen persönlichen Agent auf Opus kostenlos aus.
Ein echtes Beispiel: Ich importiere meine LinkedIn-Posts wöchentlich in Notion und habe einen Skill, der sie für die Veröffentlichung auf Medium umformatiert. Das könnte ein Agent sein – es ist eine Routineaufgabe. Aber ich muss das Ergebnis noch manuell in Medium einfügen, weil die keinen API haben. Ob die Seite vorformatiert ist, wenn ich ankomme, oder ob ich den Skill starte und 10 Sekunden warte – das ist ein Zwei-Minuten-Unterschied. Und ich bin sowieso aufmerksam dabei.
Wenn er end-to-end ohne mich liefe? Automatisch formatiert und automatisch veröffentlicht? Jeden Credit wert. Aber bis diese letzte Meile automatisiert ist, spart mir der Skill die Token.
Das Crawl-Walk-Run-Prinzip gilt auch hier. Starte mit Skills. Mach dich damit vertraut, wie KI deine Workflows handhabt. Bau Vertrauen in die Ausgabequalität auf. Dann bringe die bewährten, hochvolumigen, wirklich autonomen Flows zu Custom Agents – und zahle für Credits in dem Wissen, was du bekommst.
Ich bin locker zehnmal produktiver als noch vor einem Jahr. Aber ich merke auch, dass mein menschliches Context-Window – die Zahl paralleler KI-Threads, die ich im Kopf halten kann – an seine Grenzen stößt. Der nächste Produktivitätssprung kommt also nicht durch mehr Skills. Er kommt durch die richtigen Agents, die die richtigen Jobs autonom erledigen. Starte mit Notion Consulting. Das Schlüsselwort: richtigen.
Wenn du tiefer in die Welt der Notion-Automationen und KI-Workflows eintauchen willst: 41 kostenlose Ressourcen — Templates, Guides und ein wöchentlicher Newsletter warten auf dich.
Häufig gestellte Fragen
Wie ändere ich das Modell meines Notion Custom Agents?
Öffne die Einstellungen deines Agents, scrolle unten zu Erweitert und wähle Modell. Wähle das spezifische Modell, das zur Aufgabenkomplexität passt. Vermeide die Auto-Einstellung – sie übergibt die Modellwahl zurück an den Agent, was dir Kontrolle über Kosten und Verhalten nimmt. Auf demselben Erweitert-Bildschirm findest du eine Effort-Einstellung, die steuert, wie viel Reasoning das Modell pro Run aufwendet; lass sie auf dem Standard, es sei denn, ein hochfrequenter Agent erledigt einfache Aufgaben – dann senke sie.
Ist Haiku gut genug für Notion Agents in der Produktion?
Für zielgerichtete, wiederholbare Aufgaben: absolut. Haiku übernimmt Klassifizierung, Formatierung, Datenextraktion, Routing und Zusammenfassung zuverlässig. Es kostet ein Fünftel von Opus. Die Faustregel: Wenn die Aufgabe kein kreatives Reasoning oder komplexe mehrstufige Logik erfordert, erledigt Haiku (oder Gemini Flash oder Minimax) den Job.
Wie funktionieren Notion Credits für Custom Agents?
Notion Credits kosten 10 $ pro 1.000 Credits, werden workspace-weit geteilt und setzen monatlich ohne Übertrag zurück. Der Credit-Verbrauch hängt vom verwendeten Modell ab, davon, wie viel Kontext der Agent verarbeitet, wie viele Tools er aufruft und wie viele Schritte die Aufgabe erfordert. Einfachere Agents auf kleineren Modellen verbrauchen weniger Credits pro Run.
Was ist der Unterschied zwischen einem Notion Skill und einem Custom Agent?
Ein Skill ist ein wiederverwendbares Instruction-Set, das über deinen persönlichen Agent läuft – der in deinem Plan ohne Zusatzkosten enthalten ist. Ein Custom Agent läuft autonom auf Trigger und kostet Notion Credits. Nutze Skills für Aufgaben, die du manuell auslöst. Nutze Agents für Aufgaben, die ohne deine Aufmerksamkeit laufen müssen.
Kann ich mehrere Notion Agents miteinander verketten?
Ja. Agents können sich nicht direkt aufrufen, aber du kannst sie über Datenbank-Trigger verketten. Agent A beendet seine Aufgabe und aktualisiert eine Property oder erstellt eine Seite → Agent B wird durch diese Änderung ausgelöst. So funktioniert Multi-Agent-Orchestrierung in Notion heute. Hier ist eine vollständige Anleitung, wie man das einrichtet.